Künstliche Intelligenz
Bitgrip
LLM-Wiki: Wie wir mit einem KI-Agenten ein selbstpflegendes Wiki gebaut haben
Das Thema kurz und kompakt:
- Ein LLM-Wiki ist ein Wissensspeicher aus einfachen Textdateien, den ein KI-Agent lesen, durchsuchen und selbst pflegen kann.
- Es braucht keine Datenbank, keinen Server und keine Embedding-Pipeline. Die Ablage ist ein Ordner voller Dateien, versioniert in Git.
- Die laufenden Kosten für die Wissensbasis liegen bei null. Backups sind normale Git-Pushes.
- Jede Änderung ist nachvollziehbar: wer hat wann was geändert und warum. Das macht den Ansatz für sensible Bereiche wie Compliance interessant.
- Für sehr große Wissensbasen bleibt ein klassisches System oft die bessere Wahl. Für ein paar hundert Dokumente ist das LLM-Wiki erstaunlich stark.
- Ein LLM-Wiki ist ein Wissensspeicher aus einfachen Textdateien, den ein KI-Agent lesen, durchsuchen und selbst pflegen kann.
- Es braucht keine Datenbank, keinen Server und keine Embedding-Pipeline. Die Ablage ist ein Ordner voller Dateien, versioniert in Git.
- Die laufenden Kosten für die Wissensbasis liegen bei null. Backups sind normale Git-Pushes.
- Jede Änderung ist nachvollziehbar: wer hat wann was geändert und warum. Das macht den Ansatz für sensible Bereiche wie Compliance interessant.
- Für sehr große Wissensbasen bleibt ein klassisches System oft die bessere Wahl. Für ein paar hundert Dokumente ist das LLM-Wiki erstaunlich stark.
Ein LLM-Wiki ist ein Firmen-Wissensspeicher, der komplett aus Textdateien besteht und von einer KI selbst gepflegt wird. Statt Wissen in eine spezielle Datenbank zu laden, liegt alles als lesbarer Text im Dateisystem. Der KI-Agent kennt die Struktur, beantwortet Fragen mit Belegen und hält den Speicher aktuell.
{{summary}}
Stell dir vor, du fragst deine Firmen-Dokumentation etwas und bekommst nicht zehn halb passende Treffer, sondern eine belegte Antwort mit Quellenangabe. Kein Sucherlebnis wie bei einer Volltextsuche, sondern eine Antwort wie von einem Kollegen, der jedes Dokument im Kopf hat.
So etwas haben wir intern gebaut. Ausgangspunkt war ein leerer Ordner. Zwei Tage später stand ein lebendiger Wissensspeicher, den ein KI-Agent eigenständig pflegt. Dieser Artikel beschreibt, wie das entstanden ist, was ein LLM-Wiki ist und wann sich der Ansatz lohnt.
Was ist ein LLM-Wiki eigentlich?
Ein LLM-Wiki ist ein Wissensspeicher aus Markdown-Dateien, den ein KI-Agent liest, befragt und pflegt. Es gibt keine Datenbank und keinen Server im Hintergrund. Der gesamte Speicher ist ein Verzeichnis voller Textdateien, idealerweise in Git versioniert. Wer den Ordner kopiert, hat sofort das komplette Wissen inklusive aller Werkzeuge dabei.
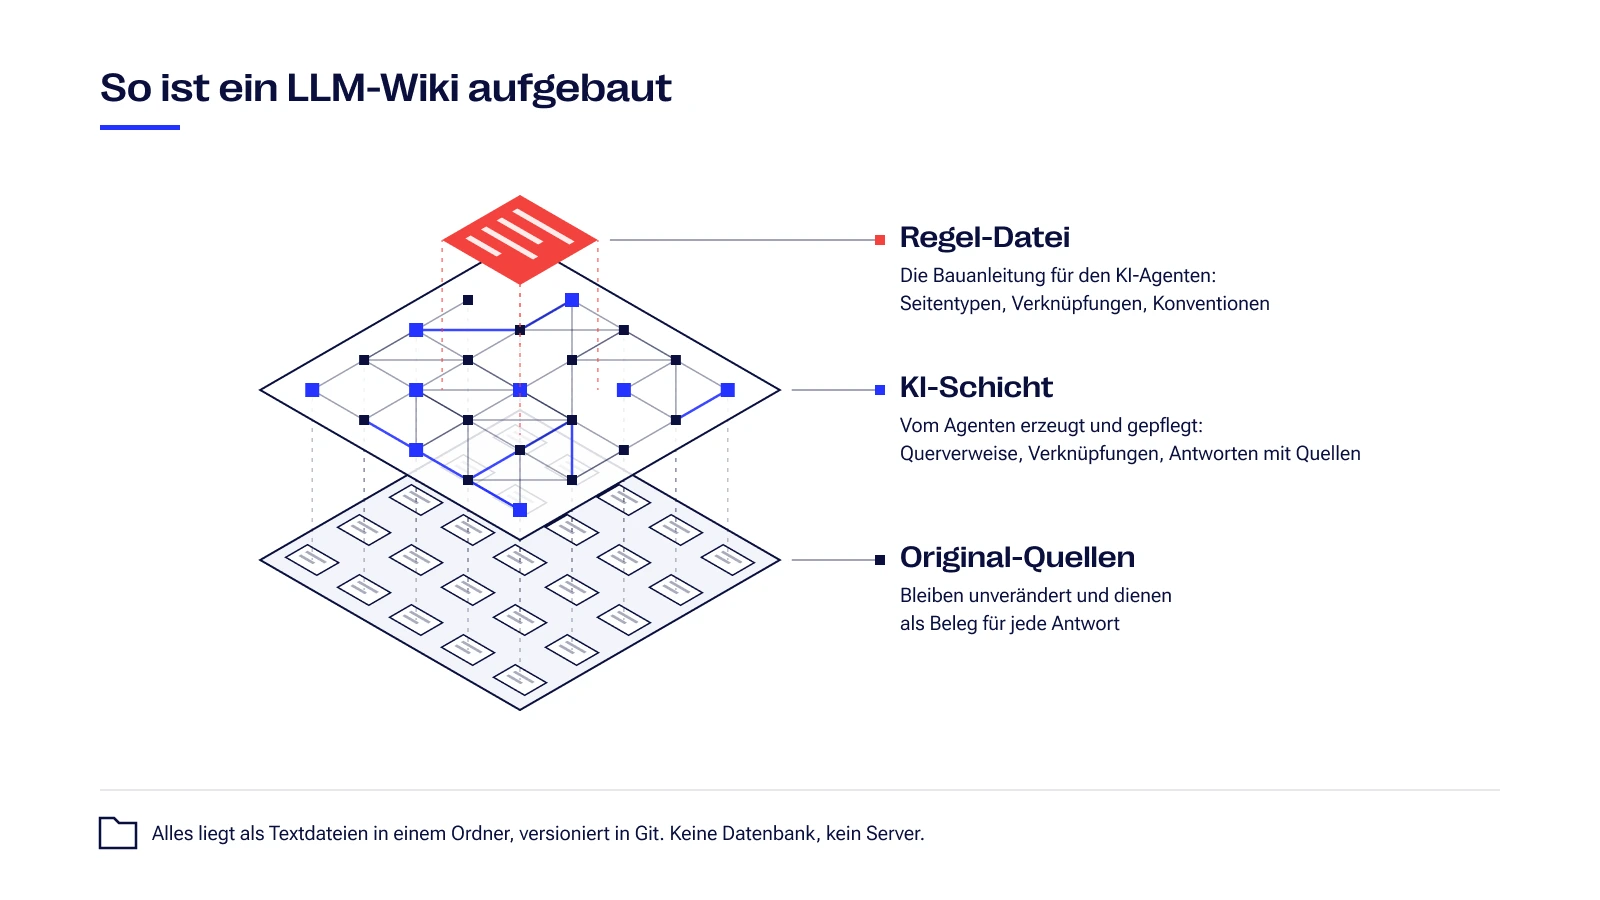
Das klingt zunächst unspektakulär. Den Unterschied macht eine einzige Regel-Datei. Sie erklärt dem Agenten, wie der Speicher aufgebaut ist: welche Arten von Seiten es gibt, wie sie verknüpft werden, welche Konventionen gelten. Diese Datei ist sozusagen die Bauanleitung. Damit wird das Wiki selbsttragend.
Ein Vergleich macht die Größenordnung greifbar. Der reine Inhalt in unserem internen Projekt umfasst rund 81.000 Wörter. Das sind etwa 85 Prozent der Wortzahl von Tolkiens „Der Hobbit“. Ein Mensch würde für einmal Durchlesen fast sieben Stunden brauchen. Für einen KI-Agenten ist das der Idealbereich: zu viel, als dass ein Mensch es im Kopf hätte, aber klein genug, dass die KI bei jeder Frage alle Quellen mitbetrachten kann.
LLM-Wiki oder klassisches KI-System: Was ist der Unterschied?
Der Unterschied liegt in der Architektur. Klassische KI-Wissenssysteme (oft RAG genannt) speichern Inhalte in einer speziellen Vektordatenbank und suchen darin nach Ähnlichkeit. Ein LLM-Wiki verzichtet darauf komplett und arbeitet direkt auf Textdateien. Weniger Technik, weniger Wartung, volle Nachvollziehbarkeit.
Damit der Unterschied klar wird, hier die wichtigsten Punkte nebeneinander:
Niemand muss eine Datenbank betreiben. Jeder Editor funktioniert, sogar die Weboberfläche von Git. Auch Kolleginnen und Kollegen ohne KI-Tool können die Inhalte lesen. Und der Wechsel auf ein anderes KI-Werkzeug kostet nichts, weil die Regeln in der Textdatei stehen und nicht in einem bestimmten System.
Wie ist unser LLM-Wiki entstanden?
Wir haben nicht groß geplant und dann gebaut. Wir haben klein angefangen und in kurzen Runden gelernt. Der Ausgangspunkt war ein bestehender interner Wissensbereich mit über hundert Dokumenten in einem sensiblen Compliance-Umfeld. Klassisch strukturiert, vollständig, aber schwer quer zu durchsuchen. Das Ziel: ein paralleler Speicher, den eine KI pflegen und über Themengrenzen hinweg durchsuchbar machen kann.
Aus unseren Projekten kennen wir das Muster: Ein starres Schema, das man vorab am Reißbrett entwirft, hält der Realität selten stand. Also haben wir es umgedreht.
„Die Regel-Datei haben wir nicht vor dem ersten Import geschrieben, sondern aus der Arbeit heraus. Jedes Problem, das einmal auftauchte, wurde zur Regel. Was wir einmal gelöst haben, soll nie wieder zurückkommen.“
Stephan Ansorge, Senior Solutions Consultant bei Bitgrip
Ein Beispiel aus der Praxis: Die Original-Quellen bleiben unverändert und dienen als Beweis. Alles, was die KI daraus erzeugt, landet in einer zweiten Schicht mit Verknüpfungen und Querverweisen. Diese saubere Trennung war die wichtigste frühe Entscheidung. Erst dadurch kann der Agent eigenständig arbeiten, ohne die Original-Belege zu verändern.
Was macht der KI-Agent?
Der Agent übernimmt drei wiederkehrende Aufgaben: Er liest neue Dokumente ein und verknüpft sie sinnvoll. Er beantwortet Fragen mit direkten Quellenangaben. Und er prüft den Speicher regelmäßig auf Widersprüche, Lücken und lose Enden. Für jede dieser Aufgaben gibt es einen festen Ablauf, den er auf Zuruf startet.
Wichtig war uns dabei die Kontrolle. Fast alle Abläufe starten nur, wenn ein Mensch sie auslöst. Die KI arbeitet also nicht unbeaufsichtigt am Wissensbestand. Neue Vorschläge, die noch nicht offiziell freigegeben sind, wandern zuerst in einen sichtbaren Zwischenbereich, bevor sie Teil der offiziellen Wahrheit werden.
Ein Prinzip hat sich immer wieder bewährt: Ein Ablauf ist kein technisches Detail, sondern festgehaltene Erfahrung. Jeder feste Ablauf ist die Antwort auf ein konkretes Problem aus dem Alltag. Das macht den Ansatz robust. Das Wissen über die Pflege des Wikis steckt im Wiki selbst.
Wo lohnt sich ein LLM-Wiki und wo nicht?
Ein LLM-Wiki lohnt sich bei überschaubaren, textlastigen Wissensbeständen von einigen hundert Dokumenten, bei denen Nachvollziehbarkeit wichtig ist. Für sehr große Bestände mit vielen tausend Dokumenten oder viel Bild-, PDF- und Videomaterial bleibt ein klassisches System oft effizienter. Fair ist, beide Grenzen offen zu benennen.
Drei Punkte sprechen dafür:
- Kosten und Betrieb. Keine Datenbank, kein Extra-Hosting für die Wissensbasis. Das senkt den Aufwand spürbar.
- Nachvollziehbarkeit. Über Git ist jede Änderung dokumentiert. Für auditrelevante Bereiche ein echter Vorteil.
- Unabhängigkeit. Der Speicher hängt an keinem bestimmten Anbieter. Ein Werkzeugwechsel ist unkompliziert.
Zwei Punkte sprechen dagegen:
- Sehr große Bestände. Bei vielen tausend Dokumenten und blitzschneller Suche über alles ist ein klassisches System meist die bessere Wahl.
- Bilder, PDFs und Videos. Solche Inhalte lassen sich nur als Anhang verknüpfen. Ein klassisches System kann sie direkt auswerten.
Viele interne Wissensbereiche liegen genau im Idealbereich des LLM-Wikis. Da spielt der Ansatz seine Stärken aus.
Warum das für Entscheider relevant ist
Für technische Verantwortliche ist es eine bewusste Architektur-Entscheidung: weniger bewegliche Teile, weniger Wartung, kein Anbieter-Lock-in. Für die Geschäftsführung zählt die einfache Rechnung: Firmenwissen wird KI-fähig, ohne dass eine teure Infrastruktur entsteht und ohne dass die Nachvollziehbarkeit leidet.
Wir haben festgestellt, dass gerade die Kombination überzeugt. Die KI ist nicht mehr nur Konsument einer Wissensdatenbank, sondern ihr aktiver Pfleger. Und weil alles aus lesbarem Text besteht, bleibt das Wissen auch dann verständlich, wenn morgen ein anderes KI-Werkzeug zum Einsatz kommt. Wie der Einstieg in KI im eigenen Unternehmen gelingt, beschreiben wir in unserem Beitrag zu AI im Engineering.
Fazit
Ein LLM-Wiki ist keine kleine Version eines großen KI-Systems, sondern ein anderer Weg. Die Wissenspflege verschiebt sich vom aufwändigen technischen Stack in einen simplen, versionierten Ordner. Damit verschwinden Infrastruktur-Sorgen, die Nachvollziehbarkeit wird selbstverständlich, und ein KI-Agent hält den Speicher aktuell.
Für Bitgrip war das Projekt auch ein Beleg für unser Prinzip, KI konsequent im eigenen Arbeitsalltag einzusetzen, bevor wir sie unseren Kunden empfehlen. Ob die eigene Plattform für solche Ansätze bereit ist, klärt unser Beitrag Wann ist deine B2B-Plattform AI-ready?
FAQ
Was ist ein LLM-Wiki?
Ein LLM-Wiki ist ein Firmen-Wissensspeicher, der komplett aus Textdateien besteht und von einem KI-Agenten gepflegt wird. Statt einer Datenbank liegt alles als lesbarer Text im Dateisystem. Die KI kennt die Struktur, beantwortet Fragen mit Quellenangaben und hält den Speicher aktuell.
Was ist der Unterschied zwischen einem LLM-Wiki und einem klassischen KI-System?
Ein klassisches KI-System speichert Wissen in einer speziellen Datenbank und sucht darin nach Ähnlichkeit. Ein LLM-Wiki arbeitet direkt auf Textdateien, ohne Datenbank und ohne Server. Das bedeutet weniger Technik, weniger Wartung und volle Nachvollziehbarkeit über Git.
Was kostet ein LLM-Wiki im Betrieb?
Für die Wissensbasis selbst fallen praktisch keine laufenden Kosten an, weil keine Datenbank und kein Extra-Hosting nötig sind. Backups sind normale Git-Pushes. Kosten entstehen nur durch die Nutzung des KI-Agenten selbst.
Für welche Wissensmengen eignet sich ein LLM-Wiki?
Der Ansatz ist stark bei textlastigen Beständen von einigen hundert Dokumenten. Bei vielen tausend Dokumenten oder viel Bild-, PDF- und Videomaterial ist ein klassisches System oft die bessere Wahl.
Kann man ein LLM-Wiki mit verschiedenen KI-Tools nutzen?
Ja. Weil die Regeln in einer Textdatei stehen und nicht in einem bestimmten System, kann jeder passende KI-Agent den Speicher lesen und pflegen. Ein Werkzeugwechsel ist dadurch unkompliziert.
Firmenwissen KI-fähig machen, ohne neue Infrastruktur
Welcher Ansatz zu deinem Unternehmen passt, hängt von Menge, Format und Sensibilität deiner Inhalte ab. Wir beraten dich bei der Auswahl und begleiten die Umsetzung, vom ersten Ordner bis zum Speicher, den eine KI zuverlässig pflegt.
Das sagen Kunden über Bitgrip
„Bitgrip hat uns mit technischer Expertise und innovativen Lösungen dabei unterstützt, unser DAM erfolgreich in CoreMedia zu integrieren. Gleichzeitig wurde die Grundlage für eine skalierbare, zukunftsorientierte Content-Management-Infrastruktur geschaffen, die unsere globalen Kommunikationsprozesse transformiert.“

Das Team von Bitgrip hat neben aller fachlichen Expertise rund um die Themen UX und UI auch immer wieder mit seiner empathischen Arbeitsweise unsere Workflows harmonisiert.

Bitgrip hat unser Projekt mit technischer Exzellenz und klarem Fokus auf unsere Ziele zum Erfolg geführt. Ihre professionelle, agile Arbeitsweise und ihr Verständnis für Business und IT haben uns nachhaltig überzeugt.
Wir arbeiten seit Jahren sehr vertrauensvoll und professionell zusammen und können uns zu 100 Prozent auf den Rat und die Leistungen von Bitgrip verlassen.


„Die Website ist ein Quantensprung für unsere Kunden, Partner und die Marke! Ohne Bitgrip hätten wir das nicht geschafft. Das Team ist der perfekte Sparringspartner.“